GPT-6.5 출시일에 대한 소문과 유출 정보가 최근 개발자 커뮤니티와 블라인드, 깃허브 오픈소스 동향을 뜨겁게 달구고 있다. 오픈에이아이(OpenAI)의 차세대 모델과 관련된 정보에 따르면, 내부 테스트 환경 및 파트너사 코드 유출을 종합해 볼 때 GPT-6.5 라인업의 상용화 시점은 2026년 하반기로 전망되고 있다.
특히 마이크론소프트의 내부 풀 리퀘스트(PR) 설정과 신규 도메인 레코드에서 차세대 모델명이 연이어 포착되면서 AI 업계의 차세대 주도권 싸움이 새로운 국면에 접어들었음을 시사한다.
최근 거대 언어 모델(LLM) 시장은 단순한 문장 생성을 넘어, 인간의 실제 업무 프로세스를 대신 처리하는 자율 에이전트(Autonomous Agent) 단계로 폭발적인 진화를 거듭하고 있다.
오픈에이아이의 차세대 모델 소식부터 앤스로픽 Fable 5.5, 제미나이 4 카본, 그리고 놀라운 가성비로 시장을 흔드는 미니맥스 M3.1과 키미 K3.1에 이르기까지 현시점 글로벌 AI 테크 판도의 핵심 변화를 밀도 있게 정리해 본다.
💡 요약해보면
- GPT-6.5 및 차세대 모델 유출: 마이크론소프트 PR 소스 코드 및 도메인 카운트다운을 통해 오픈에이아이의 GPT-6.1 Terra 및 GPT-6.5 출시 징후가 포착되었다.
- 앤스로픽 Fable 5.5의 혁신: 단순 버그 수정을 넘어 개발자의 의도와 거대한 구조적 문제 클래스를 선제적으로 인식하는 차세대 추론 능력을 제시한다.
- 가성비 모델의 반란: 미니맥스 M3.1 Flash는 기존 거대 모델 대비 1/100 수준의 비용(입력 100만 토큰당 $0.15)으로 최상위권 에이전트 성능을 증명했다.
- 하드웨어 없는 추론 속도 혁신: 엔비디아의 메가커널 퓨전 최적화를 통해 GPU 추가 없이 소프트웨어만으로 초당 423 토큰이라는 압도적 속도를 달성했다.
오픈AI의 차세대 라인업과 GPT-6.5 출시일 정보 파헤치기
open-si.lol 유출 도메인과 마이크론소프트 PR 소스 코드의 진실
최근 IT 테크 커뮤니티에서 가장 뜨거웠던 사건 중 하나는 개발자 티보(Tibo)가 구매한 `open-si.lol` 도메인의 소스 코드 분석이다.
해당 도메인의 웹 소스 코드 깊숙한 곳에서 '6.5'라는 문자열과 함께 샌프란시스코 시간 기준 2026년 11월 1일 오전 10시를 가리키는 카운트다운 타이머가 발견되면서 GPT-6.5 출시일에 대한 예측이 수면 위로 급부상했다.
티보가 개인적으로 진행하던 28일 카운트다운과 일시가 완벽히 맞아떨어졌기 때문에 수많은 엔지니어들이 이를 오픈에이아이의 비밀 발표 힌트로 해석했다.
그러나 이 도메인의 아카이브 이력을 추적해 본 결과, 지난 9월 23일 독립적인 패러디 웹사이트로 매물에 올라왔던 기록이 확인되며 해프닝으로 일단락되는 듯했다.
하지만 곧이어 마이크론소프트의 공식 풀 리퀘스트(PR) 파이프라인에서 실질적인 신호탄이 터져 나왔다.
마이크론소프트 내부 평가 설정 커밋 기록에서 18개의 평가 코멘트 항목이 기존 `GPT-5.6 Terra`에서 `GPT-6.1 Terra`로 전격 업데이트된 사실이 포착된 것이다.
트위터 개발자 Lumina에 따르면 "Microsoft updated 18 evaluation configs from GPT-5.6 Terra to GPT-6.1 Terra"라는 구체적인 인용과 함께 실제 파이프라인 설정값이 공개되었다.
구체적으로 공개된 평가 설정 파라미터는 아래와 같다.
`runs: $(RUNS=5)`, `model: $(MODEL=gpt-6.1-sol)`, `judge_model: $(JUDGE_MODEL=gpt-6.1-terra)`, `judge_reasoning_effort: $(JUDGE_REASONING_EFFORT=medium)`, `judge_timeout: $(JUDGE_TIMEOUT=10m)`, `executor: copilot-sdk`.
이는 오픈에이아이가 서브 모델인 Sol 및 Terra 버전을 필두로 GPT-6 계열의 차세대 추론 체계를 마이크론소프트 코파일럿(Copilot) 인프라 위에서 활발히 내부 테스트하고 있음을 입증하는 확실한 팩트다.
앤스로픽 Fable 5.5와 개발자의 의도를 읽는 자율 코딩의 등장
유출 소식은 오픈에이아이에만 국한되지 않는다. 앤스로픽(Anthropic) 역시 차세대 모델인 앤스로픽 Fable 5.5(가칭) 출시를 눈앞에 두고 있다는 정황이 외신 '디 인포메이션(The Information)'을 통해 보도되었다.
익명의 내부 테스터 리포트에 따르면, 이 모델은 단순히 사용자가 입력한 프롬프트 그대로 단편적인 버그를 수정하는 기존 LLM의 한계를 완전히 벗어났다.
오히려 코드를 둘러싼 시스템의 전체적인 문제 클래스를 능동적으로 파악하고, 개발자에게 "이 근본적인 구조 문제까지 함께 해결할까요?"라고 선제 제안을 건네는 수준에 도달했다.
'디 인포메이션'이 보도한 테스터의 인용문은 AI 모델이 진화해야 할 방향성을 명확히 보여준다.
"The Anthropic model is also better at thinking outside of the box rather than regurgitating common sense advice or solutions, the person said. For instance, if a user asks for advice on how to invest in stocks, rather than providing generic advice like looking at price-to-earnings ratios, the model might come up with its own creative algorithms to predict future stock performance, the person said."
즉, 단순 주가수익비율(PER) 같은 흔한 교과서적 조언을 읊는 것에 그치지 않고, 직접 주가를 예측하는 독창적인 알고리즘을 제안하는 수준의 창의적 추론을 선보인다는 뜻이다.
이러한 발전은 특히 클라우드 코딩(Cloud Code)이나 자율 코딩 에이전트 분야에서 거대한 도약을 의미한다.
개발자가 구체적인 해결책을 하나하나 지정해주지 않아도, AI가 맥락과 의도를 파악해 코드베이스 전체의 리팩토링 범위를 스스로 설정할 수 있게 되기 때문이다.
단순히 코드를 타이핑해 주는 보조 도구에서, 문제의 본질을 파악하고 기획 단계부터 개입하는 능동적 동료로의 세대교체가 이루어지고 있는 셈이다.
🔥 단순 단순 생성을 넘어선 자율 추론의 시대
기존 생성형 AI가 "A를 해줘"라는 명령에 A만 출력하는 정적인 도구였다면, 차세대 모델들은 문제의 맥락과 의도를 읽어내고 B와 C라는 근본적 위험 요소까지 역으로 지적하는 능동성을 갖추고 있다.
개발자가 미처 인지하지 못한 시스템 구조적 결함까지 AI가 먼저 파악해 제안하는 시대, 이제 엔지니어의 핵심 역량은 단순 코딩이 아닌 AI와의 고차원적 협업 능력으로 옮겨가고 있다.
레거시 프로그래밍 언어 현대화와 오픈AI Codex 라이브의 실체
기술적 화려함 뒤에서 오픈에이아이는 거대한 실무적 과제에도 집중하고 있다. 바로 코볼(COBOL), 포트란(Fortran), 비주얼 베이직(Visual Basic) 같은 레거시 프로그래밍 언어로 작성된 글로벌 인프라의 현대화 프로젝트다.
현재 전 세계 주요 은행, 정부 기관, 항공망 및 메인프레임 시스템의 상당 부분은 수십 년 전 작성된 레거시 코드로 구동되고 있다.
문제는 수십 년간 축적된 복잡한 비즈니스 로직을 이해하는 연로한 개발자들이 대거 은퇴하면서, 이를 유지보수하거나 현대적인 언어로 마이그레이션하는 작업이 사투에 가깝다는 점이다.
오픈에이아이의 최신 모델은 다양한 언어 변환 성능을 측정하는 'MultiLangBench'에서 무려 87.4%의 평균 통과율을 기록했다.
특히 가장 악명 높은 코볼(COBOL) 언어의 마이그레이션 정확도는 87.2%에 달했다.
실제로 대표적인 C언어 기반 데이터베이스 엔진인 SQLite를 코볼로 역변환 및 마이그레이션하는 고난도 실험에서, 오픈에이아이의 GPT-4 아스트라(Astra) 모델은 86.6%의 정확도를 기록하며 전환 인프라 비용을 기존 대비 19%나 절감하는 기염을 토했다.
한편 오픈에이아이는 28일간의 신기능 발표 행사 중 '15일 차'를 맞아 "We're cooked"라는 유쾌한 제목의 라이브 스트리밍을 진행했다.
방송 중 엔지니어들은 실제로 라면을 끓이면서 신규 오픈에이아이 코덱스(Codex) 및 챗GPT 스페이스(ChatGPT Space) 업데이트를 시연했다.
이날 공개된 핵심은 클라우드 환경과의 밀접한 결합이다. 개발자가 랩탑 노트북을 닫거나 퇴근하더라도, 클라우드에 상주하는 코덱스 에이전트가 백그라운드에서 빌드와 테스트, Git 워크트리 분기 및 대화 포크 작업을 끊임없이 수행하는 자율 작업 환경이 구축된 것이다.
터미널 CLI 환경과의 직접적인 상호작용은 물론, 여러 에이전트의 진행 상태를 실시간 모니터링하는 플랫폼의 기틀이 완성되었다.
구글 제미나이 4 카본의 한계와 미니맥스 M3.1의 가성비 충격
구글 제미나이 4 카본 체크포인트 성능 논란과 오퍼스 5.5 비교
한편, 테크 매체 '비즈니스 인사이더(Business Insider)'는 구글이 내부적으로 '카본(Carbon)'이라는 코드명의 제미나이 4 카본 체크포인트를 극비리에 테스트 중이라는 소식을 전했다.
IT 에널리스트 Andrew Curran 역시 트위터를 통해 "Business Insider is reporting that Google is internally testing a new Gemini 4 checkpoint named Carbon that matches Opus 5.5 in coding."이라 밝히며, 해당 모델이 앤스로픽의 클로드 오퍼스 5.5급 코딩 성능에 육박할 것이라는 기대감을 키웠다.
그러나 소문과 달리 실제 벤치마크 및 필드 테스트를 거친 현장 엔지니어들의 평가는 자못 냉정했다.
실제 카본 B 및 카본 C 체크포인트를 입수해 직접 고난도 코딩 작업을 수행해 본 결과, 앤스로픽의 오퍼스 5.5는 커녕 구글의 기존 내부 모델인 아르곤(Argon)과 비교해 보아도 코딩 품질 면에서 눈에 띄는 향상이 관찰되지 않았다.
오히려 복잡한 멀티 스레딩 로직이나 샌드박스 환경 내 프론트엔드 연동 과정에서 기존 모델보다 정교함이 떨어지거나 루프 오류에 빠지는 등 다소 실망스러운 결과를 보여주었다.
이는 대형 빅테크 기업들이 거대한 파라미터 수를 무작위로 늘리는 방식만으로는 이미 고도화된 추론 성능의 한계벽에 부딪혔음을 반증한다.
단순히 체크포인트의 물리적 크기를 키우는 '스케일링 로'만으로는 실전 코딩 영역에서 앤스로픽이나 오픈에이아이가 보유한 촘촘한 파인튜닝 노하우를 단숨에 역전하기 어렵다는 사실을 보여준 씁쓸한 사례라 할 수 있다.
📊 미니맥스 M3.1 Flash vs 주요 LLM 모델 API 가격 및 벤치마크 비교
입력 및 출력 토큰 100만 개당 비용 단위(USD) 기준 데이터다.
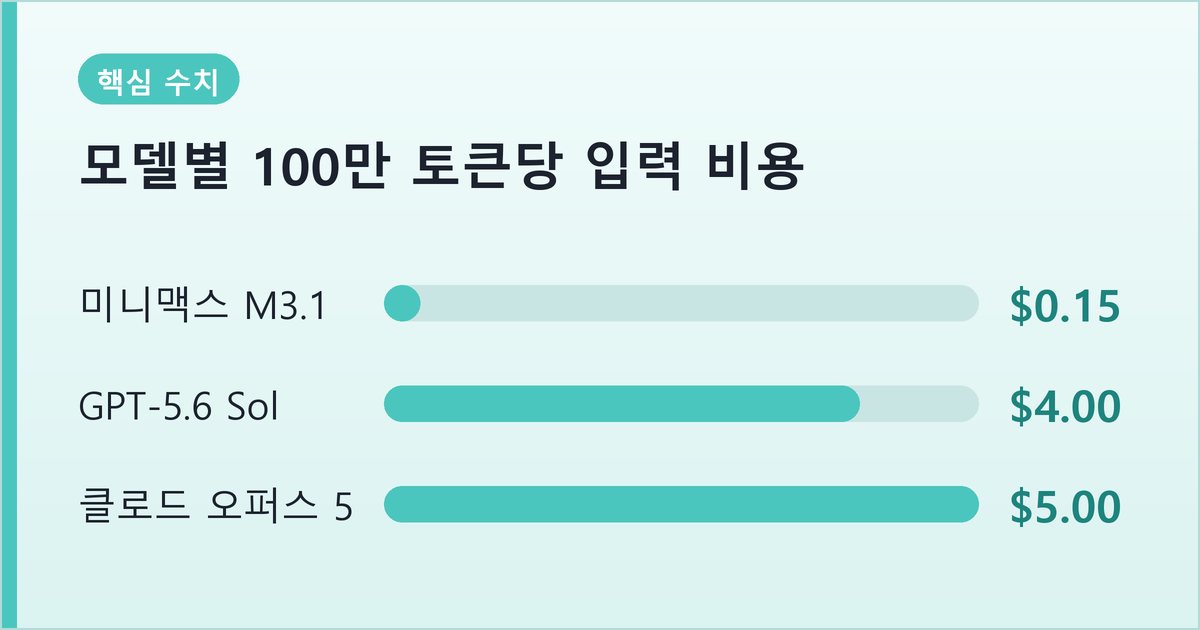
- 미니맥스 M3.1 Flash: 입력 $0.15 / 출력 $0.60 (프롬프트 캐싱: $0.015) | Automation-Bench: 62.2% | DeepSWE: 74%
- 클로드 오퍼스 5 (Claude Opus 5): 입력 $5.00 / 출력 $25.00 | Automation-Bench: 50.3%
- GPT-5.6 Sol: 입력 $4.00 / 출력 $20.00 | Automation-Bench: 45.8%
미니맥스 M3.1 Flash는 플래그십 모델 대비 무려 1/30 ~ 1/80 수준의 압도적인 가격 경쟁력을 확보하고 있다.
미니맥스 M3.1 Flash의 파격적인 벤치마크 점수와 극가성비 API 가격
빅테크들의 거대 모델 전쟁 속에서 진짜 파장을 일으킨 곳은 중국의 AI 스타트업 미니맥스(MiniMax)였다.
미니맥스가 프리뷰 단계를 마치고 정식 출시한 미니맥스 M3.1 Flash 모델은 가격 대비 성능 면에서 기존 AI 업계의 공식을 송두리째 뒤흔들고 있다.
재미있는 사실은, 얼마 전 글로벌 LLM 리더보드 상위권을 싹쓸이하며 정체를 궁금하게 만들었던 '스페이스 버니(Space Bunny) 알파' 모델이 바로 이 M3.1 Flash의 사전 테스트 버전이었다는 점이다.
M3.1 Flash 모델은 개발 과정에서 무려 200조 개 이상의 토큰을 학습했으며, 기존 세대 모델 대비 처리 속도는 3배 빨라진 반면 운영 비용은 70%나 절감했다.
객관적인 벤치마크 수치 역시 가히 파격적이다.
자동화 작업 수행 능력을 측정하는 'Automation-Bench'에서 M3.1 Flash는 62.2%를 기록, 클로드 오퍼스 5(50.3%)와 GPT-5.6 Sol(45.8%)을 가볍게 따돌렸다.
코딩 전용 벤치마크인 DeepSWE에서는 74%, 시각적 추론 벤치인 BabyVision에서는 91%, 시각 언어 평가 ALE에서는 30%를 기록하며 수천억 원이 투입된 서구권 최상위 모델들과 대등하게 맞서고 있다.
더욱 놀라운 것은 API 가격표다.
미니맥스 M3.1 Flash의 플랫 레이트(Flat Rate) 가격은 입력 토큰 100만 개당 단 $0.15, 출력 토큰 100만 개당 $0.60에 불과하다.
자주 반복되는 프롬프트 캐시 읽기 비용은 100만 토큰당 $0.015라는 사실상 '공짜'에 가까운 수준이다.
클로드 오퍼스 5가 입력 $5 / 출력 $25, GPT-5.6 Sol이 입력 $4 / 출력 $20 수준임을 감안할 때, 미니맥스는 수백 대의 자율 에이전트를 연동해 무한 루프를 돌려야 하는 개발사들에게 가뭄의 단비 같은 존재로 떠올랐다.
여기에 더해 10월 23일 가중치 공개와 함께 출시될 예정인 2조 7천억(2.7T) 파라미터 규모의 'M3.1 Pro' 모델 소식은 시장 전체를 긴장시키기에 충분하다.
수중 추격전부터 웹 사이트 스캐폴딩까지 실제 실전 코딩 테스트 비교
벤치마크 수치를 넘어 실제 개발 현장에서 수행된 실전 코딩 테스트 사례들은 미니맥스 M3.1 Flash의 무시무시한 실용성을 증명한다.
첫 번째로 진행된 하드웨어 제품 랜딩 페이지 프론트엔드 생성 테스트에서 미니맥스 M3.1 Flash와 클로드 오퍼스 5.5가 맞붙었다.
미니맥스는 해당 랜딩 페이지 전체 코드를 완성하는 데 불과 1센트($0.01)의 비용을 지출한 반면, 오퍼스 5.5는 $1.22의 비용이 발생했다.
무려 88배나 저렴하고 처리 속도 역시 4배나 빨랐던 셈이다.
비록 시각적 디자인 완성도나 디테일한 CSS 다듬기에서는 오퍼스 5.5가 근소하게 앞섰으나, 미니맥스로 전체적 골격(스캐폴딩)을 초고속으로 짜 올린 뒤 오퍼스로 디테일만 정교화하는 복합 전략을 쓴다면 개발 비용을 획기적으로 낮출 수 있다는 결론이 도출된다.
두 번째로 수행된 고난도 단일 HTML 파일 기반 '수중 잠수함 추격 게임' 시각적 코딩 시나리오 테스트 결과 역시 흥미롭다.
4단계의 캔버스 그래픽 및 파티클 연산 코딩 작업에서 각 모델별 소요 시간과 비용은 다음과 같았다.
미니맥스 M3.1 Flash: 29분 소요, 비용 약 $0.21.
딥시크(DeepSeek) V4.1 Flash: 27분 소요, 비용 약 $0.38.
제미나이(Gemini) 3.8 Flash: 40분 소요, 비용 약 $1.43.
클로드 하이쿠(Haiku) 5.5: 35분 소요, 비용 약 $0.17.
절대적 단가는 하이쿠가 살짝 낮았으나, 미니맥스는 제미나이보다 7배나 저렴하고 딥시크보다 1.8배 저렴하면서도 훨씬 안정적인 프레임 레이트를 유지했다.
이어 진행된 복잡한 '테슬라 로드스터 경찰 추격 3D 가상 영상 재현' 렌더링 코딩 테스트에서도 미니맥스는 $2.34의 비용만을 소요하며 $3.07이 든 딥시크 V4.1 Flash 대비 24% 향상된 가성비로 완벽한 동적 시각 코드를 구현해 냈다.
글로벌 AI 모델의 고도화와 추론 효율성 혁신
키미 K3.1과 딥시크 V4.1 Flash의 엔비디아 메가커널 퓨전 기술
중국 AI 연구진의 역습은 미니맥스에서 그치지 않는다.
Moonshot AI의 옴니(Omni) 모델인 키미 K3.1(Kimi K3.1)은 최근 sglang PR 테스트 데이터가 유출되며 베일을 벗었다.
키미 K3.1은 4가지의 독립된 추론 깊이 옵션(`low`, `medium`, `high`, `max`)을 제공하며 기본값으로 `max` 체계를 채택했다.
이미지 입력을 공식 지원하며 확장된 토크나이저 구조를 공유한다.
더욱 경이로운 소식은 엔비디아(Nvidia)의 센트 ML(Cent ML) 팀과의 협업 결과물이다.
엔비디아 연구진은 vLLM 엔진 내 디코딩 커널을 Cuda DSL 기반의 '메가커널 퓨전(MegaKernel Fusion)' 기술로 극도로 최적화했다.
이 기술을 통해 무려 2.8조(2.8T) 파라미터에 달하는 초거대 키미 K3.1 모델을 돌리면서 사용자당 초당 423 토큰(423 tokens/sec/user)이라는 기적적인 추론 속도를 달성했다.
동일한 하드웨어 아키텍처 환경에서 기존 대비 무려 1.68배(68%)의 속도 향상을 오직 소프트웨어 커널 최적화만으로 이끌어낸 것이다.
엔지니어링 팀이 밝힌 인용문은 향후 인프라 경쟁의 패러다임이 어디로 향하고 있는지를 명확히 보여준다.
"We're not even changing the model or upgrading the GPUs. Yet, we're getting nearly 70% more generation speed simply through better software."
한편, 오픈코드(OpenCode) 플랫폼을 통해 전격 무료 공개된 딥시크(DeepSeek) V4.1 Flash 1017 모델 역시 이러한 고속 추론 파이프라인을 탑재해 개발자 생태계 흡수 속도를 높이고 있다.
여기에 큐엔 4(Qwen 4) 및 큐엔 K3.1 모델 역시 얼리 액세스 출시를 예고하고 있어, 오픈소스와 경량화 AI 시장의 속도 경쟁은 더욱 가열될 전망이다.
Z.AI Set Code의 워크플로우 모드와 GLM Omni 멀티모달 연구
개발 도구의 UI/UX 측면에서도 일대 혁신이 일어났다.
Z.AI의 코딩 플랫폼 'Set Code'는 최근 '워크플로우 모드(Workflow Mode)'라는 대규모 업데이트를 전격 단행했다.
과거에는 단일 대화창 안에서 AI가 순차적으로 코드를 작성해 주길 기다려야 했다면, Set Code의 워크플로우 모드는 개발자가 10개 이상의 서브 에이전트(Sub-agent)를 동시에 오케스트레이션할 수 있게 해준다.
실제 데모에서는 10개의 독립적인 서브 에이전트가 각자 담당한 모듈(DB 스키마 설계, API 엔드포인트 작성, 프론트엔드 컴포넌트, 유닛 테스트 구축 등)을 동시에 병렬로 작성하면서 실시간으로 진행 상황을 시각화 패널에 업데이트하는 장관을 연출했다.
AI가 모든 것을 뭉뚱그려 대답하는 대화형 구조에서 탈피해, 개발자가 관제탑의 컨트롤러처럼 에이전트들의 일감을 할당하고 관리하는 진정한 '멀티 에이전트 타워' 구조로 탈바꿈한 것이다.
이와 함께 Z.AI 연구진이 발표한 신규 논문에서는 멀티모달 파운데이션 모델인 'GLM Omni'의 연구 결과가 공개되었다.
다가오는 GLM 5.5의 핵심 엔진이 될 GLM Omni는 시각적 이미지 생성과 정교한 이해를 단일 네트워크에서 동시에 처리한다.
특히 정교한 이미지-텍스트 정렬(Image-Text Alignment) 알고리즘 개편을 통해 정밀 복합 이해 정확도를 기존 12.57%에서 26.86%로 2배 이상 끌어올렸다.
사후 학습(Post-training) 기술에 집중한 GLM 5.3의 경우, 기본 모델의 구조 변경 없이 포스트 트레이닝만으로 터미널 벤치(TerminalBench) 점수를 4.6에서 28.3으로 무려 6배 이상 폭등시키는 기적을 선보였다.
💭 개발 현장에서 느낀 사후 학습(Post-training)의 공포
과거에는 '더 좋은 AI'를 만들기 위해 수천억 원짜리 GPU 클러스터를 빌려 처음부터 Pre-training을 새로 돌리는 것만이 답인 줄 알았다. 하지만 GLM 5.3 사례나 엔비디아의 메가커널 최적화를 보면 완전히 판이 바뀌었다.
동일한 아키텍처와 이미 훈련된 가중치 위에서 포스트 트레이닝 및 소프트웨어 튜닝만으로 터미널 점수가 6배 오르고 속도가 70% 향상되는 것을 보면, 결국 승부처는 하드웨어 덤핑이 아닌 정교한 데이터 오케스트레이션과 소프트웨어 융합 기술에 있음을 뼈저리게 느낀다.
앤스로픽 OSS 스캐너와 드림랩스 Dream-1 로봇 파운데이션 모델
AI 에이전트가 코드를 쏟아내는 시대가 되면서 보안에 대한 우려도 비례하여 커지고 있다.
이를 해결하기 위해 앤스로픽은 글로벌 오픈소스 프로젝트를 위한 무료 보안 진단 도구인 'OSS 스캐너(OSS Scanner)'를 전격 공개했다.
이 스캐너는 오픈소스 리포지토리를 주기적으로 자동 스캔하여 시큐리티 취약점을 발견할 뿐만 아니라, 단순히 경고를 뜨는 수준을 넘어 실제 공격 위험을 증명하는 개념 증명(PoC, Proof of Concept) 코드와 이를 해결할 수 있는 수정 패치(Patch) 코드를 동시에 자동 생성해 메인테이너에게 전달한다.
무분별한 AI 코드 양산으로 위협받는 오픈소스 생태계에 강력한 세이프가드 보호막이 형성된 것이다.
한편, 가상 세계를 넘어 물리적 현실 세계를 제어하는 로보틱스 분야에서도 결정적인 균열이 일어났다.
그동안 스텔스(Stealth) 상태에 숨어있던 스타트업 드림랩스(DreamLabs)가 로봇 파운데이션 모델인 '드림-1(Dream-1)'을 전격 발표하며 세상에 모습을 드러냈다.
드림-1은 사전에 명시적으로 훈련받은 적이 없는 완전히 생소한 환경이나 한 번도 접해보지 않은 물체를 만났을 때, 양팔 로봇(Dual-arm Robot)이 즉석에서 상황을 인식하고 실시간으로 정교한 물리 제어를 수행할 수 있도록 설계된 모델이다.
공개된 Dream API는 개발자들에게 시간당 단 $3라는 저렴한 비용으로 제공된다.
과거 특정 공정이나 특정 제품을 집기 위해 수개월간 로봇을 하드코딩 재훈련시켜야 했던 로봇 공학계에, 재훈련 없이 즉시 현장에 투입할 수 있는 파운데이션 모델의 가능성을 열어젖힌 획기적인 사건이다.
AI 에이전트 현장 도입 사례와 실무 적용에서의 과제
국내 주요 기업들의 AI 에이전트 도입 실태와 생산성 혁신
2024년까지의 AI 도입이 단순히 홈페이지 구석에 'Q&A 챗봇'을 붙여놓는 수준에 머물렀다면, 현시점 기업들의 움직임은 차원이 다르다.
단순 대화를 넘어 회사 내부 ERP, CRM, GitHub, 레거시 DB와 연동되어 스스로 계획을 세우고 실제 실무를 처리하는 '일하는 AI 에이전트'가 기업의 필수 인프라로 안착했다.
국내 주요 선도 기업들의 실제 현장 도입 사례를 들여다보면 그 변화의 속도가 실로 매섭다.
삼성전자 DS부문은 반도체 생산라인의 복잡한 공정 데이터 및 수율 분석에 멀티 에이전트 시스템을 적용했다.
엔지니어가 수십 개의 모니터링 대시보드를 일일이 대조하던 과거와 달리, 에이전트가 수만 개의 센서 로그와 장비 파라미터를 스스로 상호 참조하여 수율 저하 의심 구간을 보고서 형태로 정밀 작성해 올린다.
이를 통해 불량 원인 분석 시간을 평균 30% 이상 단축하는 성과를 거두었다.
네이버 역시 사내 HR 시스템을 에이전트 구조의 '하이퍼케어'로 재설계하여 직원 1인당 HR 정산 문의 및 서류 처리 시간을 월 평균 40분에서 12분으로 대폭 줄였다.
신한은행은 기업여신 심사역을 지원하는 리서치 에이전트를 도입해 기업 공시와 크레딧 메모, 업종 리포트를 자동 통합 분석함으로써 심사 전 자료조사 시간을 절반으로 줄였다.
쿠팡은 물류 센터 배송 예외 지연 건을 자동 선제 처리하는 에이전트를 운영 중이며, SK텔레콤은 배포 체크리스트와 Git PR의 장애 위험도를 과거 이력 기반으로 점수화하는 리뷰 에이전트를 가동해 배포 후 롤백률을 획기적으로 낮췄다.
자율 코딩 에이전트 Devin 사례와 환각 현상의 근본적 위험성
글로벌 시장에서도 이러한 변화는 도도한 흐름이다.
Cognition Labs가 개발한 세계 최초의 AI 소프트웨어 엔지니어 'Devin(데빈)'이나, 미국 이커머스 기업 ShopFast, 핀테크 스타트업 PayNimbus의 사례는 자율 에이전트가 조직의 구조 자체를 바꾸고 있음을 증명한다.
PayNimbus의 경우 기존 6명이던 핵심 개발팀을 시니어 엔지니어 3명과 자율 코딩 에이전트 조합으로 재편한 결과, 신규 기능 출시 주기를 3주에서 1주로 단축했다.
개발자 1명이 과거 5명의 생산성을 감당하는 '메가 개발자(Mega Developer)' 시대가 열린 것이다.
그러나 이러한 거대한 효용 뒤에는 커다란 위험 요소가 도사리고 있다. 바로 거대 언어 모델의 치명적 약점인 '환각(Hallucination)' 현상과 보안 위협이다.
AI 모델이 존재하지 않는 라이브러리 패키지를 참조하여 코드를 작성하고, 이를 개발자가 검증 없이 빌드할 경우 악의적인 해커가 해당 이름의 악성 패키지를 맘포스에 올려 시스템을 감염시키는 '소프트웨어 공급망 공격(Dependency Confusion)'에 무방비로 노출될 수 있다.
오픈에이아이가 최근 발표한 자기 비판적 연구 논문에 따르면, AI 모델의 환각이 지속되는 근본 원인은 '모르면 모른다고 답하는 것'보다 '그럴듯한 오답이라도 내놓는 것'에 더 높은 점수를 부여하는 현재의 벤치마크 평가 방식과 잘못된 인센티브 구조에 있다.
특히 법률 문서나 금융 심사, 의료 코드 작성과 같이 1%의 오류도 허용되지 않는 실무 환경에서 AI 에이전트를 무비판적으로 자율 운용하는 것은 시한폭탄을 들고 있는 것과 같다.
🔥 AI 에이전트 무조건 도입이 가져올 재앙
에이전트에게 셸(Shell) 권한과 API 키, Git 배포 권한을 직접 부여하면서 적절한 격리 샌드박스(Sandbox)와 인간 승인 절차(Human-in-the-loop)를 마련하지 않는 기업들이 늘고 있다.
AI 에이전트가 작성한 코드와 시스템 변경 사항은 반드시 인간의 엄격한 가이드라인과 CI/CD 보안 검증을 거쳐야 하며, 디폴트 차단 및 권한 최우선 격리 원칙을 적용해야만 기업 인프라의 붕괴를 막을 수 있다.
EU AI 법안 규제 흐름 속에서 기업이 갖춰야 할 거버넌스 전략
AI 기술이 자율적 실행 단계로 넘어감에 따라 전 세계 정책 당국의 규제 칼날도 매서워지고 있다.
유럽연합이 세계 최초로 통과시킨 'EU AI 법안(EU AI Act)'은 AI 시스템을 위험 등급(금지된 위험, 고위험, 제한된 위험, 최소 위험)으로 세분화하고, 고위험 AI 시스템에 대해 엄격한 투명성과 위험 관리 의무를 강제하고 있다.
특히 만능 범용 모델(General Purpose AI)에 대해서도 상세한 학습 데이터 출처 공개와 데이터 저작권 준수, 정기적인 위험 평가를 집행 가능한 법적 의무로 명시했다.
이러한 글로벌 규제 흐름 속에서 AI 에이전트를 도입하려는 기업은 단순한 생산성 추구를 넘어 거버넌스(Governance) 체계를 구축해야 한다.
첫째, 모든 에이전트 활동(실행된 명령, 파일 변경, 외부 API 호출 기록)을 수정 불가능한 불변 감사 로그(Audit Log)로 남겨 중앙 SIEM 체계에 연동해야 한다.
둘째, 개인정보 및 내부 비밀 시크릿(Secret) 정보가 AI 프롬프트에 직접 하드코딩되어 유출되지 않도록 HashiCorp Vault나 KMS 같은 시크릿 관리 시스템과 결합해야 한다.
셋째, 가장 중요한 것은 모든 에이전트의 주요 의사결정 지점에 'Human-in-the-loop(인간의 개입 및 최종 승인)' 단계를 필수적으로 남겨두는 것이다.
아무리 뛰어난 성능의 GPT-6.5나 클로드 Fable 5.5 모델이라 할지라도, 최종 생산 배포나 대금 정산, 고객 데이터 삭제와 같은 비가역적 액션은 사람이 버튼을 누르도록 설계하는 것만이 AI 시대에 기업의 비즈니스를 지키는 유일한 방파제다.
❓ 자주 묻는 질문
Q. GPT-6.5 출시일과 마이크론소프트 유출 정보는 무엇인가요?
open-si.lol 도메인 소스 코드에서 발견된 카운트다운과 마이크론소프트의 내부 PR 설정 업데이트를 통해 GPT-6.1 Terra 및 GPT-6.5 라인업의 출시 징후가 포착되었습니다. 마이크론소프트 내부 평가 설정에서 gpt-6.1-sol 및 gpt-6.1-terra 모델명이 명시되었으며, 업계에서는 2026년 하반기를 상용화 시점으로 전망하고 있습니다.
Q. 앤스로픽 신모델 Fable 5.5의 주요 특징은 무엇인가요?
앤스로픽 Fable 5.5는 단순한 문장 답변이나 단편적 버그 수정을 넘어, 개발자의 의도와 전체 시스템의 구조적 문제 클래스를 선제적으로 파악하는 자율 추론 능력을 갖췄습니다. 주식 투자 요청 시 독창적인 예측 알고리즘을 제안할 정도로 틀을 깨는 창의적 문제 해결 능력이 강화되었습니다.
Q. 구글 제미나이 4 카본 성능에 대한 평가는 어떤가요?
구글 내부에서 코드명 'Carbon'으로 테스트 중인 제미나이 4 체크포인트는 앤스로픽 오퍼스 5.5급 코딩 성능을 목표로 개발되었으나, 실제 필드 테스트 결과 기존 아르곤(Argon) 모델 대비 확연한 코딩 향상이 관찰되지 않거나 디테일에서 떨어지는 등 다소 아쉬운 평가를 받고 있습니다.
📚 이 글이랑 같이 보면 좋은 글

이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
GPT-6.5 출시일에 대한 기대감부터 미니맥스 M3.1이 몰고 온 극가성비 혁명까지, 현시점 AI 시장은 단 몇 달 만에 기존 질서가 뒤바뀌는 대격변을 겪고 있다.
거대한 파라미터를 앞세운 빅테크의 힘싸움 사이에서, 이제 진짜 승부는 "이 AI가 실제 현장에서 인간의 일을 얼마나 정확하고 안전하게 대행할 수 있는가"로 옮겨갔다.
기술의 화려한 벤치마크 숫자에 현혹되기보다, 정교한 거버넌스와 사람 중심의 통제권을 바탕으로 이 강력한 자율 에이전트 도구를 자신의 무기로 길들이는 자만이 다가올 시대의 주도권을 쥐게 될 것이다.
거침없이 밀려드는 AI 에이전트의 파도 속에서, 당신의 조직은 과연 일을 맡길 준비가 되어 있는가.
#GPT65출시일 #앤스로픽Fable55 #제미나이4카본 #미니맥스M31 #키미K31 #오픈AI #마이크론소프트 #AI에이전트 #자율에이전트 #LLM트렌드 #인공지능소식 #클로드코딩 #오픈AI신모델 #소프트웨어개발 #기술유출 #테크이슈 #AI트렌드 #개발자커뮤니티 #딥시크V41 #엔비디아커널 #멀티모달AI #AI거버넌스 #챗봇추천 #생성형AI #업데이트정보 #IT뉴스 #신기술소식 #AI도입 #업무자동화 #미래기술


0 댓글