DeepSeek V4.1 Flash 1017 모델이 공개되자마자 전 세계 개발자 커뮤니티가 발칵 뒤집혔다. 결론부터 확실하게 짚고 넘어가자면, 이번 1017 체크포인트는 모델 덩치를 무식하게 키우지 않고 사후 학습(post-training)만으로 프론티어급 AI 코딩 성능과 자율 에이전트 작업 능력을 수직 상승시킨 압도적인 가성비 종결자다.
매달 천정부지로 치솟는 API 비용 청구서를 보며 식은땀을 흘리던 엔지니어들에게 그야말로 구원투수가 등장한 셈이다. 파라미터 크기 경쟁에만 매달리며 천문학적인 구독료를 요구하던 기존 빅테크들의 독점 구도에 묵직한 카운터펀치를 날렸다고 본다.
딥시크 V4.1의 이번 행보는 오픈 소스 진영의 완벽한 실리적 승리다.
과거 윤석열 씨 재임 시절만 하더라도 실체 없는 장밋빛 R&D 구호만 난무했을 뿐, 정작 현장의 개발자와 연구자들은 삭감된 예산과 비싼 외산 인프라 비용에 허덕여야 했다. 기술의 실용성과 가성비가 얼마나 중요한지 뼈저리게 체감해 온 입장에서, 이번 업데이트가 시사하는 바는 결코 가볍지 않다.
사후 학습으로 완성된 파레토 개선과 가벼운 아키텍처
💡 요약해보면
- 기존 모델의 뼈대를 그대로 유지하면서 오직 사후 학습만으로 벤치마크 점수를 2~11점 대폭 끌어올렸다.
- 552B 백본에 196B 엔그램 메모리를 얹었지만, 실제 토큰당 활성 파라미터는 단 8B에 불과한 고효율 구조다.
- 1M 토큰의 거대한 컨텍스트와 384K 출력 한도를 지원하면서도 토큰당 890바이트 수준의 캐시 메모리만 소모한다.
체크포인트 1017의 정체와 파레토 개선
10월 17일에 전격 공개된 DeepSeek V4.1 Flash 1017은 완전히 백지상태에서 새로 만든 모델이 아니다. 지난 9월에 첫선을 보였던 V4.1-Flash 베이스 모델을 정교하게 다듬어 낸 사후 학습 체크포인트 버전이다.
그럼에도 업계가 경악하는 이유는 성능 향상의 폭이 어설픈 마이너 업데이트 수준을 아득히 뛰어넘었기 때문이다. "이것은 새로운 세대가 아니라, 9월 V4.1-Flash의 신선한 사후 학습 체크포인트입니다."라는 현장의 평가가 정확하다.
보통 AI 모델의 성능을 올리려면 천문학적인 GPU를 갈아 넣어 파라미터 수를 뻥튀기하거나 추론 속도를 희생시키는 것이 일종의 불문율처럼 여겨졌다. 그러나 딥시크는 비용 구조를 단 1원도 올리지 않은 채 응답 속도와 정확도만 날카롭게 갈아 끼웠다.
이들이 당당하게 내세운 '파레토 개선(Pareto Improvement)'이라는 단어는 결코 허세 섞인 마케팅 용어가 아니었다. "DeepSeek가 부르는 '파레토 개선'이란, 아무것도 희생하지 않고 더 나은 점수와 빠른 속도를 얻는 것을 의미합니다."라는 설명 그대로다.
이건 기술적 오만함이 아니라 영리한 엔지니어링의 정수다. 주머니 사정이 팍팍한 개인 개발자나 초기 스타트업 입장에서 모델 성능이 올랐다고 해서 비용까지 두세 배로 뛴다면 아무런 의미가 없다.
기존 인프라 환경과 예산 테이블을 고스란히 유지하면서 성능만 윗단계로 도약시키는 파레토 개선이야말로 지금 인공지능 업계에 가장 절실했던 미덕이다.
552B 백본과 8B 활성 파라미터의 영리한 설계
구조를 들여다보면 감탄이 절로 나온다. 552B(백본 파라미터)에 196B(엔그램 메모리 파라미터)가 결합된 거대한 뼈대를 갖추고 있지만, 실제로 연산에 관여하는 토큰당 활성 파라미터는 단 8B 수준에 불과하다.
거대한 두뇌 용량을 확보해 두고도 실제로 말을 하고 코드를 짤 때는 꼭 필요한 신경망 8B만 활성화하여 극단적인 속도와 효율을 챙긴 것이다.
여기에 1M에 달하는 방대한 컨텍스트 윈도우와 단일 응답 기준 최대 384K 토큰이라는 경이로운 출력 범위를 제공한다. 대규모 프로젝트의 코드베이스 전체를 통째로 집어넣고 분석하기에 부족함이 없는 광활한 공간이다.
더욱 놀라운 점은 메인 어텐션 캐시 기준으로 토큰당 메모리 소모량이 고작 890바이트에 불과하다는 사실이다. 인프라 운영 비용을 갉아먹는 주범인 KV 캐시 메모리 병목을 기가 막히게 틀어막았다.
강화 학습(Reinforcement Learning)을 집요하게 적용하여 단순 질의응답을 넘어 게임 제작이나 3D 모델링 같은 엔드 투 엔드 프로젝트 수행 능력을 비약적으로 끌어올린 점도 돋보인다.
하드웨어 스펙만 믿고 방만하게 모델을 굴리던 서구권 빅테크들의 독점적 오만함에 경종을 울리는 구조적 혁신이다.
프론티어 모델을 압도한 AI 코딩 성능 벤치마크
🔥 거품 빠진 벤치마크의 충격
천문학적인 자본과 GPU 클러스터로 무장한 독점 폐쇄형 모델들이 가벼운 오픈 웨이트 모델에게 무릎을 꿇었다.
소프트웨어 엔지니어링 실전 테스트에서 Claude Opus 5와 GPT-5.6-Sol을 완전히 따돌렸다.
소프트웨어 엔지니어링과 프로그램 작성 벤치마크
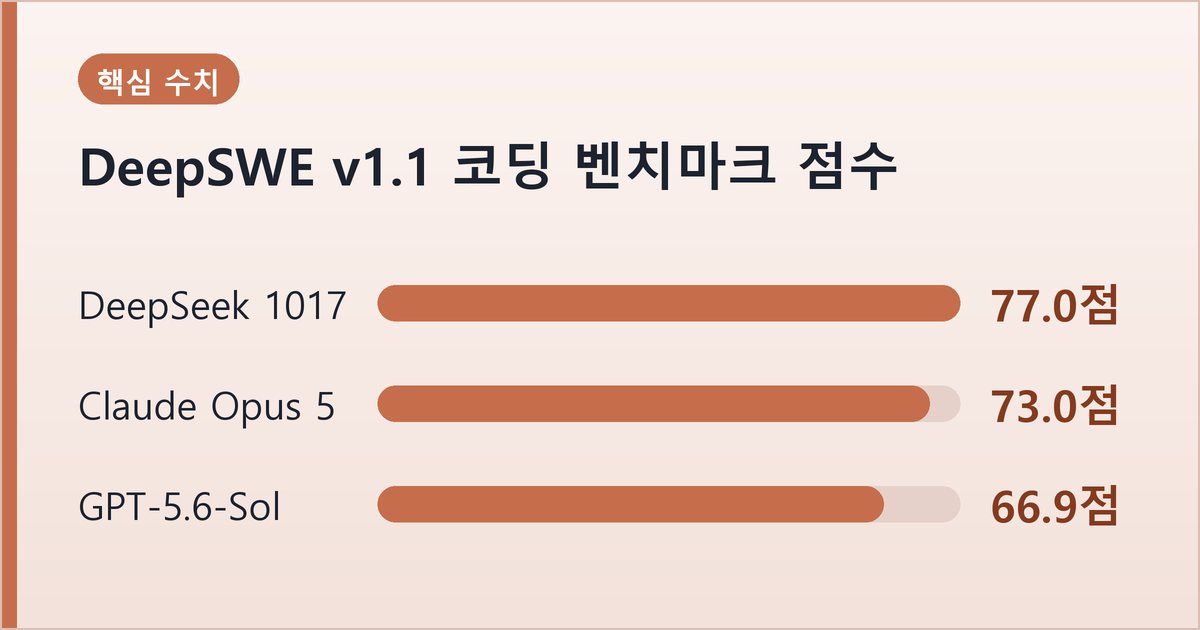
실제 엔지니어링 현장의 가혹한 테스트 환경에서 DeepSeek V4.1 Flash 1017 모델이 보여준 수치는 충격적이다. 실제 복잡한 코드베이스와 산더미 같은 버그 리포트를 던져주고 자율적으로 오류를 수정하게 만드는 DeepSWE v1.1 테스트에서 1017 모델은 무려 77.0점을 뿜어냈다.
이는 업계 최고 존엄이라 불리던 Claude Opus 5의 73.0점은 물론, GPT-5.6-Sol의 66.9점을 가볍게 제치고 당당히 1위에 오른 기록이다.
아무것도 없는 빈 도화지 상태에서 엔드 투 엔드로 프로그램을 스스로 짜 올리는 ProgramBench에서도 29.1점을 기록하며 2위를 차지했다. 기존 대비 무려 43%의 상대적 개선을 이뤄내며 Opus 5를 제외한 시장의 모든 기성 모델을 저 멀리 밀어냈다.
자연어 지시문을 곧바로 디렉터리 구조가 잡힌 깃허브 코드 저장소로 뽑아내는 NL2Repo-Bench에서도 68.2점으로 2위에 안착하며, Kimi와 GLM, 심지어 GPT-5.6을 10점 이상의 압도적인 격차로 따돌렸다.
데이터 센터의 서버 랙
코딩 벤치마크 판도를 완전히 뒤흔든 이 결과를 두고 "1017 모델은 Claude Opus 5를 3점 차이로, GPT-5.6-Sol을 4점 차이로 이겼습니다. 전체 릴리스 중 가장 명확한 코딩 승리입니다."라는 감탄이 쏟아져 나온 것은 지극히 당연하다.
거대 자본을 무기로 폐쇄적인 API 생태계를 구축해 온 거대 기업들이 긴장할 수밖에 없는 명확한 팩트다.
환경 내 자율 수행을 입증한 Terminal-Bench 4.0
단순히 문법에 맞는 코드를 출력하는 것과 복잡한 CLI 환경 안에서 셸 명령어를 치고, 에러 로그를 읽어가며 끝까지 프로그램을 구동시키는 것은 차원이 다른 문제다. 에이전트가 터미널 환경에 던져졌을 때 스스로 문제를 해결하고 작업을 완료하는지 측정하는 Terminal-Bench 4.0에서 1017 모델은 42.3점을 획득하며 1위를 찍었다. "이것이 1017이 가장 강력한 지점"이라는 분석이 정확히 들어맞는다.
이 결과는 기존 순위표의 허리를 완전히 잘라냈다. GLM 5.1(3)과 GPT-5.6-Sol(6)을 단숨에 제치고 두 모델의 머리 위로 훌쩍 뛰어오르는 완벽한 '리프프로그(leap-frog)'를 달성했다. "Both GLM 5.1-3 and GPT 5.6-Sol... Opus 5 still leads by 9.5, but still pretty impressive to improve that quickly and that much."라는 현장의 평가는 이 추격전이 얼마나 숨 막히게 전개되고 있는지를 생생히 증명한다.
비록 단일 환경 추론에서 Opus 5가 여전히 9.5점 차이로 앞서 있지만, 모델의 덩치와 가벼운 호출 비용을 감안하면 이 정도의 맹추격은 거의 재앙에 가까운 위협이다. 복잡한 환경에 모델을 던져두고 "끝날 때까지 알아서 해봐"라고 맡길 수 있는 실질적인 체력이 마침내 경량 모델에서도 완벽하게 터져 나왔다.
에이전트 모델의 자율 완결성과 워크플로 파괴력
📊 실전 워크플로 지표가 증명하는 가치
Automation-Bench v1.0.6에서 기록한 60.5점은 이번 릴리스에서 가장 눈여겨봐야 할 데이터다.
Opus 5를 10.2점 차이로 따돌리고, GPT-5.6-Sol을 거의 15점 앞섰다. 실무 자동화의 왕좌가 완전히 바뀌었다.
Automation-Bench와 멀티스텝 워크플로
비즈니스 현장에서 요구하는 AI 에이전트는 결코 한 번의 프롬프트로 시나 수필을 멋들어지게 뽑아내는 챗봇 따위가 아니다. 다양한 외부 툴을 연쇄적으로 호출하고(chaining), 스프레드시트와 데이터베이스를 오가며 비즈니스 프로세스 전체를 에러 없이 엔드 투 엔드로 끝마치는 체질이 필수적이다.
바로 이 멀티스텝 워크플로 자동화 역량을 시험하는 Automation-Bench v1.0.6에서 DeepSeek V4.1 Flash 1017은 60.5점이라는 괴물 같은 점수를 기록했다.
이 수치는 이번 발표의 모든 벤치마크 중 가장 거대한 격차를 보여준 하이라이트다. "This is its biggest lead anywhere, 10.2 points ahead of Opus 5 and nearly 15 ahead of GPT 5.6-Sol. If you automate a lot of workflows, this is the row to care about."라는 단언이 결코 과장이 아니다.
복잡다단한 사내 워크플로를 자동화하려는 엔지니어라면 오직 이 지표 하나만 보고도 모델을 갈아탈 이유가 충분하다.
수십 단계에 달하는 툴 체이닝 과정에서 길 잃지 않고 컨텍스트를 유지하는 힘, 불필요한 장황함을 걷어내고 컴팩트하게 다음 액션을 호출하는 간결함이 이 압도적인 점수 차이를 만들어냈다. 자본과 인력이 부족한 팀일수록 이런 고효율 멀티스텝 에이전트 모델의 존재는 가뭄의 단비와도 같다.
Agents' Last Exam과 Apex Bench의 경제적 가치
악명 높은 난이도로 정평이 난 '인류의 마지막 시험'에서 이름을 딴 Agents' Last Exam 결과도 마찬가지다. 고의로 극악무도하게 설계된 장기 에이전트 과제들로 채워져 있어 기라성 같은 대형 모델들조차 20점대나 30점대 늪에서 허우적거리는 잔혹한 시험대다.
여기서 1017 모델은 35.4점을 찍으며 명백한 단독 1위에 등극했다. "Clear first place, 6.8 points ahead of Opus 5, which on a test this hard is a wide margin."라는 말마따나 이처럼 극한의 난이도에서 벌린 6.8점 차이는 그야말로 넘을 수 없는 사차원의 벽이다.
전문 애널리스트나 스페셜리스트에게 고액의 보수를 지급하고 맡길 법한 경제적 가치를 지닌 실무를 다루는 Apex Bench v1.1에서도 72.1점을 획득했다. 지난 9월 모델 대비 7.5점이나 폭등한 수치다.
DeepSeek 측의 공식 발표에 따르면 심지어 최저 노력 설정(lowest effort setting)으로 작동시켜도 72%의 성공률을 그대로 유지하며, 작업당 소요되는 비용은 고작 15~20센트에 불과하다고 한다.
고액 연봉자의 며칠 치 분석 업무를 단돈 몇백 원에 에이전트가 척척 처리해 주는 세상이 코앞까지 성큼 다가왔음을 실감한다. "사후 학습이 AI 모델에 얼마나 거대한 차이를 만드는지 보여주는 사례입니다."라는 평가에 고개를 끄덕일 수밖에 없다.
도구 사용의 유무와 한계의 명암
물론 1017 모델이 모든 영역에서 만능 신(神)인 것은 아니다. 수천 개의 전문 수학, 과학, 인문학 질문으로 구성되어 웹 검색이나 코드 인터프리터 같은 도구를 일절 쓸 수 없는 순수 지식 및 내부 추론 테스트인 Humanity's Last Exam (No Tools)에서는 42.6점이라는 가장 뼈아픈 성적표를 받아 들었다. "The weakest row, 42.6 overall... and 13.7 points behind Opus 5. So the frontier clearly wins when it comes to humanities' last exams with no tools."라는 지적대로, 순수한 지적 체급 싸움에서는 Kimi K3나 GPT-5.6-Sol 뒤로 처졌고 Opus 5에게는 무려 13.7점이나 뒤처졌다.
하지만 도구(Tools)가 쥐어지는 순간 판도는 180도 뒤집힌다. 차트를 읽고 그래프에서 숫자를 뽑아 시각자료를 분석하는 Chartography (With Tools)에서는 83.0점을 기록하며 Opus 5의 턱밑까지 바짝 따라붙었다.
초기 프론티어 모델들이 모조리 0점을 맞으며 좌절했던 시각적 퍼즐 기반의 ZeroBench-Main (With Tools)에서도 51.0점을 찍으며 49.0점에 그친 GPT-5.6-Sol을 꺾었다.
GPT-5.6-Sol이 이 벤치마크 역사상 패배한 단 두 번 중 하나가 바로 이 51 대 53 패배였다는 점은 매우 시사하는 바가 크다.
도구 없이 머릿속 암기력만으로 버티는 시험에서는 대형 프론티어 모델이 이길지 몰라도, 외부 도구를 쥐여주고 손발을 쓰게 만드는 순간 가벼운 1017 모델이 대등하거나 오히려 앞선다. "에이전트 벤치마크는 모델을 환경에 던져놓고 작업이 실제로 완료되었는지 판단합니다. 단순히 답이 맞는지가 중요한 게 아닙니다."라는 격언이 이 모델의 본질을 꿰뚫고 있다.
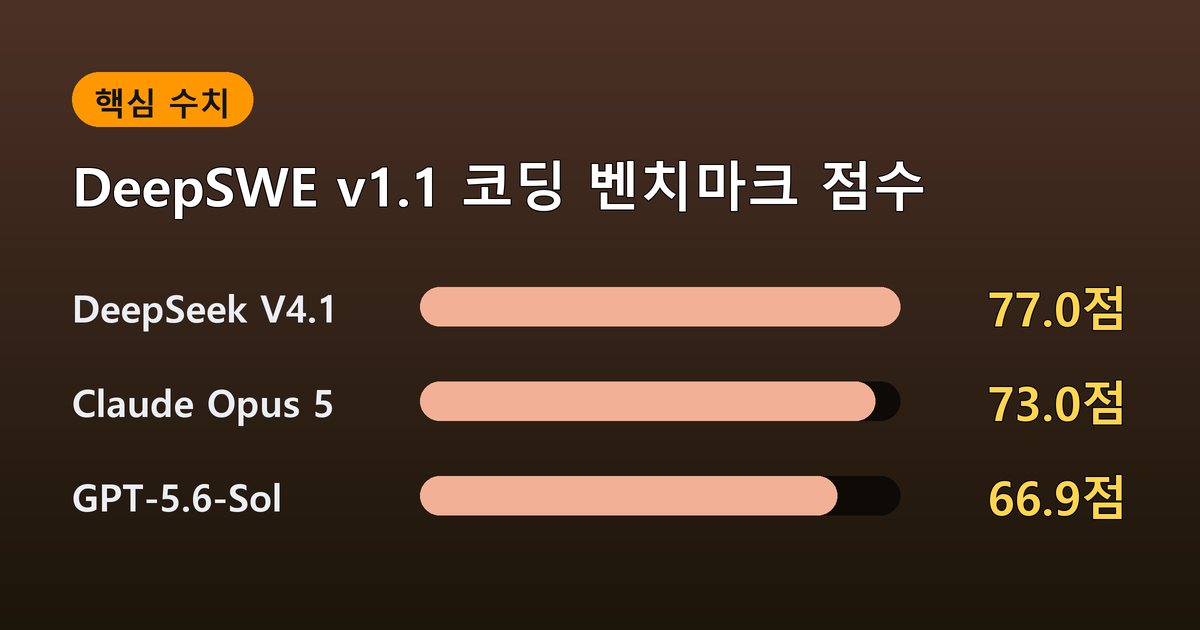
DeepSWE v1.1 코딩 벤치마크 점수
MIT 라이선스와 파격적인 비용 효율성
💭 개인적인 생각
비용 효율성과 오픈 웨이트 라이선스가 가져올 생태계 변화를 체감하고 있다. 과거에 값비싼 폐쇄형 API에 의존해 작은 사이드 프로젝트나 프로토타입을 돌리다가 월말 청구서를 보고 소스 코드를 폐기했던 쓰라린 경험이 떠오른다.
기술이 아무리 뛰어나도 그것을 만지고 실험할 수 있는 비용이 통제되지 않는다면, 결국 소수 독점 자본의 전유물로 전락할 수밖에 없다. MIT 라이선스로 소스 가중치를 활짝 열어젖히고, 피크 시간대에도 100만 토큰당 입력 0.30달러, 출력 1.20달러라는 파격적인 단가를 제시하는 모습에서 진정한 기술 민주화의 길을 엿본다.
오프피크 시간대 50% 할인까지 감안하면 그야말로 압도적이다. 이제 거대 플랫폼에 휘둘리지 않고 독립적인 시스템을 구축할 수 있는 단단한 토대가 마련되었다.
토큰당 단가 구조와 Search and Fetch API의 개방
개발자 입장에서 당장 계산기를 두드리게 만드는 핵심은 비용이다. DeepSeek V4.1 Flash 1017의 요금 체계는 가히 공격적이다.
캐시된 입력 토큰(Input tokens)은 피크 시간대 기준 1백만 토큰당 단 0.30달러이며, 출력 토큰(Output tokens)은 1.20달러에 불과하다. 심지어 딥시크의 오프피크 창(off-peak window)을 활용해 배치 작업을 돌리면 여기서 추가로 50% 할인이 더 들어간다.
여기에 에이전트의 눈과 귀가 되어줄 자체 웹 검색 레이어 'Search and Fetch API'를 전격 공개했다. 호출 성공 1천 건당 고작 0.75달러라는 극도로 저렴한 요금을 책정했을 뿐만 아니라, 실패한 호출에 대해서는 비용을 전혀 청구하지 않는다.
더욱 파격적인 것은 2026년 11월 1일까지 DeepSeek Harness, Claude Code, Codex 등을 통해 이 강력한 검색 기능을 전면 무료로 개방했다는 점이다.
에이전트는 작업 특성상 스스로 생각하고 도구를 호출하는 '긴 루프(long loops)'를 돌며 상상을 초월하는 양의 토큰을 집어삼킨다. 이런 워크로드에서 다단계 도구 호출에 능숙하면서도 쓸데없는 미사여구를 배제해 출력 토큰을 절약해 주는 1017 모델의 존재는 개발 비용의 지형을 근본적으로 바꿔놓을 수밖에 없다.
MIT 라이선스 오픈 웨이트 모델의 무게감
성능보다 더 무서운 무기는 바로 배포 방식이다. DeepSeek V4.1 Flash 1017은 상업적 이용과 수정, 재배포에 아무런 제약이 없는 완전한 MIT 라이선스의 오픈 웨이트 모델이다.
언제든 서비스 정책을 바꾸고 가격을 인상할 수 있는 빅테크 기업의 손바닥 위에서 불안하게 서비스를 운영할 필요가 없어졌다.
개발자들은 모델 가중치를 로컬 인프라나 자체 클라우드 인스턴스에 내려받아 폐쇄망 환경에서도 안전하게 구동할 수 있다. 기업 내부의 민감한 기밀 코드나 개인정보가 포함된 비즈니스 데이터를 외부 API 서버로 유출할 걱정 없이 마음껏 에이전트 오케스트레이션 시스템에 통합할 수 있는 길이 열린 것이다.
오픈 소스 소프트웨어가 지난 수십 년간 IT 인프라의 표준을 장악해 왔듯, 인공지능 역시 결국 개방형 아키텍처가 승리할 것이라는 확신을 준다. 폐쇄적인 생태계로 고객을 가두려던 독점 기업들의 벽이 이번 오픈 웨이트 릴리스로 인해 더욱 빠르게 허물어지고 있다.
자체 보고 데이터의 한계와 실전 프로덕션 함정
장밋빛 찬사가 쏟아지고 있지만, 엔지니어라면 언제나 행간(fine print)을 날카롭게 읽어내야 한다. 취재 노트에서도 명확히 짚고 넘어가듯, 현재 공개된 화려한 수치들은 DeepSeek 측이 가장 유리한 조건에서 측정한 자체 보고(self-reported) 데이터라는 점을 잊어서는 안 된다.
독립적인 글로벌 리더보드에서 재현성 검증(rerun)을 마치기 전까지는 이들의 '최선의 쇼케이스'로 한 발짝 물러서서 냉정하게 바라볼 필요가 있다.
실제 도구 설정(Tool settings)의 차이가 벤치마크 점수를 얼마나 극단적으로 왜곡하는지도 명확히 드러났다. Terminal-Bench 테스트에서 딥시크는 Claude Code, DeepSeek-SWE, Mini-SWE-V2, SWE-bench 환경을 가동하면서 무려 5번의 시도 중 단 한 번만 성공해도 '패스(Pass)'로 판정하는 느슨한 기준을 적용했다.
엄격한 1회성(one-shot) 검증을 거치는 다른 라이벌 기업들의 평가 잣대와는 결이 다를 수 있다는 뜻이다.
게다가 실전 프로덕션 레벨에서는 예기치 못한 운영 리스크가 도사리고 있다. 실제로 글로벌 커뮤니티에서는 기존 모델 엔드포인트(deepseek-chat 등)가 갑작스럽게 중단되면서 레거시 파이프라인이 멈춰 서거나, n8n 같은 자동화 툴과 연동할 때 OpenAI의 'Use Responses API' 옵션 충돌로 404 에러를 뿜어내는 등 API 규격 및 인프라 차이로 인한 시스템 장애 사례가 보고되기도 했다.
긴 추론 시간으로 인한 타임아웃 문제와 화웨이 칩 의존도에 따른 인프라 공급망 우려, 그리고 실무 투입 시 발생할 수 있는 환각(Hallucination) 현상 역시 방심할 수 없는 복병이다.
또한 최근 GPT-5.6 Sol을 24시간 동안 실제 비즈니스 운영에 자율 에이전트로 투입했다가, 엉뚱한 스팸 발송과 거짓 응답으로 447달러의 금전적 손실을 초래했던 뼈아픈 실패 사례는 AI 모델을 다루는 우리에게 많은 시사점을 던져준다.
전문가들의 분석대로 이는 모델 자체의 한계라기보다는 적절한 가드레일을 설정하지 못한 인간 관리자의 책임이 크다. 아무리 뛰어난 모델이라도 맹신하지 말고 촘촘한 오케스트레이션과 모니터링 체계를 갖추어야만 파멸적인 비용 폭탄과 장애를 피할 수 있다.
Agent OS 연동과 10분 만의 3D 레이서 빌드
이러한 한계와 주의점에도 불구하고, 실전 활용성 면에서 이 모델이 선사하는 사용자 경험은 경이롭다. Agent OS 내부 환경에서는 DeepSeek Harness 섹션, OpenCode 코더 빌트인 환경, 그리고 DeepSeek Carna 하네스 세션을 통해 단 한 번의 토글 클릭만으로 손쉽게 V4.1-Flash로 모델을 스위칭할 수 있도록 통합 생태계를 완성해 두었다.
실제 시연에서 보여준 파괴력은 에이전트의 미래를 명확히 보여준다. OpenCode 환경에 진입하여 아케이드 감성의 3D 레이서 게임(`neon-rush - sunset-circuit.html`) 제작을 프롬프트 하나로 지시하자, 놀랍게도 단 10분 만에 완전한 실행 파일로 코드를 빌드해 냈다.
비록 완벽무결한 상용 수준은 아니고 약간의 자잘한 버그는 엿보였으나, 단 한 번의 원샷(one-shot) 시도로 화려한 그래픽과 부드러운 속도감을 갖춘 3D 브라우저 게임을 뽑아낸 것은 그 자체로 경이로운 성취다.
"The short version is: the best cheap agent model you can call today, still a clear step behind Opus 5 on hard reasoning."라는 총평이 가슴 깊이 와닿는다.
순수 고난도 추론에서는 여전히 Opus 5의 거대한 산맥이 버티고 서 있을지언정, 오늘 당장 현업에서 지갑 걱정 없이 호출하여 무한에 가까운 작업을 위임할 수 있는 가장 강력하고 저렴한 에이전트 모델이라는 사실에는 추호의 의심도 없다.
❓ 자주 묻는 질문
Q. DeepSeek-V4.1-Flash-1017의 주요 특징은 무엇인가요?
파라미터 규모를 늘리지 않고 사후 학습(post-training)만으로 성능을 날카롭게 개선한 파레토 개선 모델이다. 552B 백본에 196B 엔그램 메모리를 갖췄지만 토큰당 활성 파라미터는 8B에 불과하며, 1M 컨텍스트 윈도우와 384K 최대 출력을 지원하여 매우 가볍고 빠르다.
Q. 코딩 및 에이전트 벤치마크 성능은 기존 모델과 비교해 어떤가요?
실제 버그를 수정하는 DeepSWE v1.1에서 77.0점을 기록해 Claude Opus 5와 GPT-5.6-Sol을 꺾고 1위를 차지했다. 멀티스텝 비즈니스 워크플로를 테스트하는 Automation-Bench에서도 60.5점으로 Opus 5를 10.2점 차이로 크게 앞서는 등 실무 에이전트 영역에서 막강한 성능을 보여준다.
Q. MIT 라이선스와 웹 검색 API 무료 사용 기간은 어떻게 되나요?
상업적 제약이 없는 오픈 웨이트 MIT 라이선스로 배포되어 누구나 자유롭게 내부 시스템에 통합할 수 있다. 아울러 새롭게 추가된 'Search and Fetch API' 웹 검색 레이어는 2026년 11월 1일까지 DeepSeek Harness, Claude Code, Codex 등을 통해 완전 무료로 이용 가능하다.

이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
DeepSeek V4.1 Flash 1017은 인공지능이 더 이상 거대 테크 기업들의 비싼 장난감이 아니라는 사실을 명백히 보여주었다. 가벼운 몸집에 강력한 실전 코딩 체력을 얹어 파레토 개선을 이뤄낸 이 모델은 전 세계 개발자들에게 진정한 기술적 자유를 안겨주고 있다.
언제나 독점과 오만함은 혁신을 가로막고, 개방과 공유는 생태계를 풍요롭게 살찌운다. 거품 낀 마케팅에 휘둘리지 않고 진짜 현장의 문제를 해결해 주는 실용적인 인공지능이 마침내 우리 곁에 도착했다.
결국 세상을 바꾸는 것은 요란한 선언이 아니라, 누구나 쓸 수 있게 문턱을 낮춘 단단한 기술이 아닐까 싶다.
#DeepSeek #딥시크 #DeepSeekV4 #AI코딩 #오픈소스AI #인공지능 #개발자 #머신러닝 #소프트웨어엔지니어링 #프론티어모델 #파레토개선 #에이전트모델 #AI모델 #테크뉴스 #프로그래밍 #API비용 #오픈웨이트 #MIT라이선스 #AI벤치마크 #딥러닝 #개발자도구 #AI기술 #테크트렌드 #빅테크 #자율에이전트 #코드생성 #AI연구 #소프트웨어개발 #신기술 #개발자소통


0 댓글